Hoy vengo a hablar de una funcionalidad que no mucha gente utilizaba hace unos años pero ahora con la Inteligencia artificial no podemos vivir sin ella si trabajas en local.
Imaginate estar trabajando en varias funcionalidades en paralelo, sobre el mismo repositorio, esto no funciona bien, porque si trabajas en una sola carpeta, todo se pisa entre sí, tres agentes trabajando en paralelo van a estar tocando los ficheros de los demás, para ello git tiene una solución, los worktrees.
Anteriormente no se utilizaban mucho, ya que los casos solían ser más cuando ibas a revisar código o ayudar a alguien tenías un worktree con tus cambios y cambiabas a otro con los cambios de la otra persona. Pero como digo, hoy por hoy, es super necesario.
Tabla de contenidos
1 - Qué es un Worktree en Git?
Los worktrees son una funcionalidad que nos permite tener varias carpetas de trabajo asociadas al mismo repositorio.
Y para comprenderlos tenemos que saber diferenciar entre un branch o rama si lo decís en español y carpeta, parece algo sencillo y obvio pero se nos puede complicar, ya que un branch es la referencia a un commit, y la carpeta tiene los archivos que vamos a modificar.
Y cuando cambiamos de branch, lo que git hace por detrás es cambiar los ficheros de dicha carpeta para poder trabajar sobre el branch elegido.
Tener worktrees nos permite tener otra carpeta distinta, apuntando a otro branch pero en el mismo repositorio.
Para poner un ejemplo podemos hacerlo con mi proyecto de Distribt pero esto funciona en cualquier lado.
Imagina que estás añadiendo un servicio nuevo, y otra persona está arreglando un bug, tu puedes estar trabajando en tu branch principal tarea-1234 en la carpeta original, cuando tu compañero te pide que revises el bug en tu máquina para ver si está arreglado puedes cambiar a dicho worktree que por detrás se llamará “bugs” o algo similar y poner su branch en ese worktree. En tu sistema de ficheros también tendrás una carpeta llamada “bugs” que hace referencia al worktree.
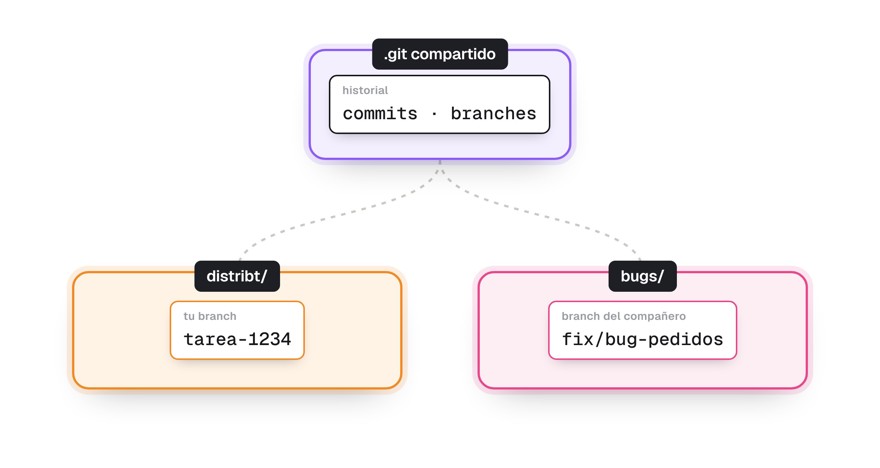
En este caso he utilizado un worktree existente, pero también es común crear un worktree por tarea, en ese caso el propio bug podría tener su propio worktree. O si estás trabajando con agentes en multiples tareas a la vez puedes tener algo como
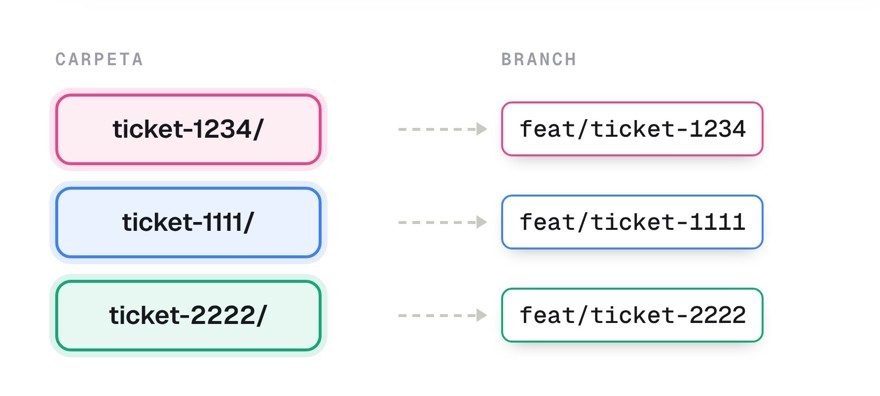
Por debajo los worktrees comparten objetos Git, tanto los commits o las referencias a los branches, pero a su vez contienen su propioHEAD, su área de staging y sus diferentes archivos, por eso puedes preparar un cambio en uno mientras compruebas algo distinto en otro sin afectarse entre sí.
2 - Trabajando con worktrees
Pese a que eso era el punto principal del post, y que la IA le dices que haga un worktree y te hace los comandos y ya, creo que es importante tener claros, y entender, al menos las partes clave.
Para este punto vamos a ver nuestro proyecto de antes. Con remoto llamado origin y la rama principal es main, que es lo más normal si tenemos todo por defecto.
2.1 - Crear un worktree
Para crear un worktree, pongámonos en la situación donde hemos mergeado algo, y vamos a trabajar en el ticket-123. Corremos los siguientes comandos en la terminal:
git fetch origin
git worktree add -b feat/ticket-123 ../ticket-123 origin/main
Que hemos hecho aquí?
El primer comando, ha actualizado nuestra información.
El segundo tiene varias partes de entender.
-b feat/ticket-123indica que queremos crear un branch nuevo.../ticket-123es la carpeta donde vamos a trabajarorigin/maines nuestro punto de partida
Y no se puede tener el mismo branch activo en dos worktrees.
2.2 - Trabajar con el nuevo worktree
Si bien es cierto, que ciertas interfaces de usuario, como la propia de github desktop, hacen la vida mucho más sencilla, en la terminal no es mucho más complicado.
Acabamos de crear nuestro worktree y para trabajar en él lo que tenemos que hacer es entrar en él para ello simplemente entramos en la carpeta
cd ../ticket-123 Y ya está, podemos trabajar como siempre, hacemos nuestros cambios y hacemos el push.
git add .
git commit -m "example message"
git push -u origin feat/ticket-123
Y de aquí podemos crear una pull request completamente normal.
2.3 - Eliminar worktrees
Has creado la PR, y se ha hecho merge, simplemente no ignores esa carpeta con los ficheros ni la dejes abandonada en tu ordenador, porque al final, van a terminar siendo muchos, pero muchos gigas y te colapsan el disco.
Lo que tenemos que hacer es eliminar el worktree.
Para ello tan sencillo como, estando fuera de la carpeta del worktree, corremos el siguiente comando
git worktree remove ../ticket-123
Este comando elimina tanto la carpeta y su registro como el worktree. El branch feat/ticket-123 sigue existiendo, así que también tenemos que correr un comando para ello:
git branch -d feat/ticket-123Ojo, no realices estas acciones antes de hacer el merge de la pull request.
2.4 - Revisar otros branches sin afectar a nuestro trabajo
Otra herramienta muy común, que ya mencione antes es la de comprobar el trabajo ajeno, pero no queremos que esto nos afecte a nosotros, para ello vamos a utilizar la opción --detach, que lo que hace es dejar ese worktree en un commit concreto sin dejar un branch local activo.
Para ello ejecutamos el siguiente comando:
git worktree add --detach ../ticket-999 origin/feat/ticket-999
Ahora podemos abrir el proyecto, ejecutar los test y comprobar el funcionamiento mientras tenemos nuestro desarrollo en la otra carpeta.
Ojo, esto es a un commit en concreto, si más adelante ese branch del ticket-999 tiene cambios, no se actualiza de forma automática, simplemente haz un fetch y ejecuta el comando switch de git:
cd ../ticket-999 <-- (la carpeta del ticket que estamos mirando)
git fetch origin
git switch --detach origin/feat/ticket-999
Así se vuelve a poner en el último commit de la rama remota.
3 - Qué contiene cada carpeta o worktree
Puedes pensar que lo que acabamos de hacer es tener varios entornos completamente independientes, y no es así, porque lo único que estamos haciendo es separar los entornos de trabajo. El resto de configuración va a depender de cómo esté montada la aplicación.
Por ejemplo, si tienes un fichero ignorado por git, como suele ser el .env, este no se copia a los nuevos worktress. Lo mismo sucede con dependencias o los ficheros resultantes de una compilación en .NET, al crear el worktree hay que hacer otra build completa.
Por supuesto lo mismo aplica a la configuración, si tu la tienes para que escuche por un puerto específico, y pones a correr dos aplicaciones, ambas van a intentar usar el mismo puerto, llamar a la misma base de datos, etc, imagino que coges la idea.
Para ejecutar versiones en paralelo tendremos que montar toda la infraestructura y configuración necesaria para permitir dicha funcionalidad, aunque con aspire es bastante más sencillo hoy en día de lo que era hace unos años.
Conclusión
Antes de la llegada de la IA, utilizar worktrees te podia resultar util para situaciones concretas, ya que muy poca gente trabajaba en dos o tres tareas simultáneas. Hoy en día me parece algo que tenemos que utilizar en nuestro día a día.
Comentarios